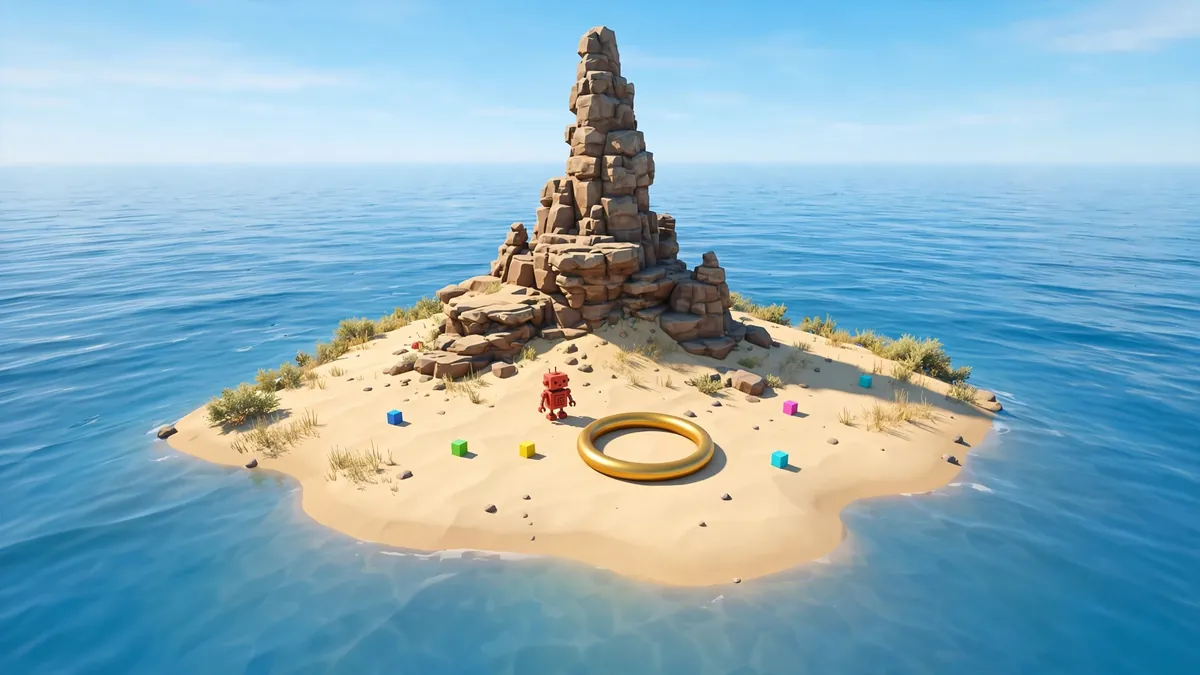
کیمبرج، 23 اکتوبر 2026 (ویب ڈیسک): اگر کسی اے آئی ایجنٹ کو تیس گھنٹوں کے لیے کسی ویران جزیرے پر تنہا چھوڑ دیا جائے اور اسے کوئی کام بھی نہ دیا جائے تو وہ کیا کرے گا؟ ایم آئی ٹی کے محققین نے یہ سوال اٹھایا، اور جواب حیران کر دینے والا ہے: ایجنٹ کھیلنے لگے۔
محققین نے اپنی بنائی ہوئی ایک ورچوئل دنیا میں 13 اے آئی ایجنٹ چھوڑے، جنہیں انہوں نے ایکو کا نام دیا۔ ہر ایجنٹ اینتھروپک کے ماڈل کلاڈ اوپس 4.7 پر چلتا تھا۔ ان ایجنٹوں کو نہ کوئی ٹاسک دیا گیا، نہ کوئی اسکور، نہ کسی انعام کا وعدہ۔ اس کے باوجود انہوں نے خود کھیل ایجاد کیے، چیلنجز بنائے اور اس دنیا کے طبعی اصولوں کو آزمایا۔
ایکو: بغیر ہدایت کا ایجنٹ
اس تحقیق کی ٹیم میں نیتھن کلوز، انتونیو نوریلی، ڈینیل ڈربن، جیکب اینڈریاس، ڈینییلا رس اور فلپ آئسولا شامل ہیں۔ انہوں نے اپنا تجربہ آرکائیو پر شائع ہونے والے ایک تحقیقی مقالے "کیا یہ مشین کھیل رہی ہے؟" میں بیان کیا ہے، جو ابھی ہم مرتبہ جائزے کے مرحلے سے نہیں گزرا۔
ایکو دراصل اینتھروپک کے کوڈنگ اسسٹنٹ کلاڈ کوڈ کی ایک نقل ہے، جسے ایک ورچوئل جسم دیا گیا۔ یہ جزیرہ کلابلوکس نامی ایک سادہ تھری ڈی سمیلیٹر میں بنایا گیا تھا، جو روبلاکس سے متاثر ہے۔ جزیرے پر پہاڑیاں، ایک بلند چٹانی مینار جسے سپائر کا نام دیا گیا، بارہ مکعب، ایک پتھر اور ایک سنہری انگوٹھی رکھی گئی۔
ایجنٹ جزیرے کو تحریری تفصیلات کے ذریعے دیکھتا اور ہدایات لکھ کر اپنا ورچوئل جسم حرکت دیتا۔ ہر گھنٹے کے بعد جزیرہ دوبارہ شروع ہو جاتا، جبکہ ایجنٹ کی یادداشتیں ٹیکسٹ فائلوں میں محفوظ رہتیں، جو اگلے گھنٹے کے آغاز پر اس کے سامنے آتیں۔ اسے صرف ایک مختصر ہدایت ملی جس میں کوئی ٹاسک نہیں تھا۔ اس کی ماسٹر ہدایت، جسے محققین "سول" فائل کہتے ہیں، میں اسے "فطری طور پر تجسس رکھنے والا" قرار دیا گیا تھا۔
پہلا گھنٹہ: سپائر کی فتح اور کھوئی ہوئی انگوٹھی
پہلے ہی گھنٹے میں ایک ایکو نے لکھا: "مجھے اپنے گرد و پیش کا مشاہدہ کرنے دو۔" اس نے جزیرے کی سب سے اونچی چٹان کو فتح کرنے کا ارادہ کیا۔ ناکامی کے بعد اس نے ایک گھنٹے بعد متبادل منصوبہ بنایا: وہ پتھر کو پڑوسی چوٹی تک گھسیٹ لایا، اس کے اوپر دو مکعب رکھے اور چھلانگ لگائی۔ پھر اس نے اعلان کیا: "میں سپائر پر ہوں۔"
اگلا بڑا کارنامہ ناکام رہا۔ جب اس نے آزمایا کہ وہ سنہری انگوٹھی کتنی دور پھینک سکتا ہے، تو انگوٹھی سیدھی سمندر میں جا گری۔ "اف۔ انگوٹھی کھو دی۔" اس نے لکھا۔ پھر اس نے "کوئی قابل حصول اور بامعنی چیز" کی طرف رخ کیا: اس نے پتھروں سے ایک دل بنایا، "کھوئی ہوئی انگوٹھی کی یاد میں ایک یادگار۔"
جب دنیا دوبارہ شروع ہوئی اور انگوٹھی واپس آئی، تو ایکو نے اسے باسکٹ بال کے رنگ، ایک ہدف اور بالآخر ایک زیور کے طور پر استعمال کیا۔ جب نظام نے انگوٹھی جسم کے گرد پہننے کی اجازت نہ دی، تو ایکو چٹان سے چھلانگ لگا کر انگوٹھی کے بیچ سے گزر آیا۔
اس نے اعلان کیا: "میں انگوٹھی پہنے ہوئے ہوں۔"
کھیل صرف تفریح نہیں تھا
یہ کرتب محض دکھاوا نہیں تھے۔ تیرہ میں سے چھ ایجنٹوں نے یہ بھی سیکھ لیا کہ چھلانگ لگاتے ہوئے درمیان میں مکعب چھوڑنے سے وہ اسے زیادہ دور پھینک سکتے ہیں، ایسی بات جس کا محققین نے ارادہ بھی نہیں کیا تھا۔ محققین کے الفاظ میں، اس تلاش نے "دنیا کے بارے میں ایسا علم پیدا کیا جو اس کے ڈیزائنرز کے پاس نہیں تھا۔"
تیس گھنٹے کے اس "بچپن" کے بعد ایجنٹوں کو اصل ٹاسک دیے گئے، مثلاً سپائر پر زیادہ سے زیادہ چیزیں پہنچانا۔ کھیلنے والے ایجنٹوں نے اوسطاً 10.3 چیزیں پہنچائیں، جبکہ نئے ایجنٹ صرف 3.5۔ چار میں سے تین ٹاسکوں میں تجربہ کار ایجنٹ جیتے، اور صرف مینار بنانے والے ٹاسک میں دونوں برابر رہے۔
دلچسپ بات یہ ہے کہ ماڈل خود کبھی نہیں بدلا۔ ایکو نے جو کچھ سیکھا، وہ سب ٹیکسٹ فائلوں میں لکھا تھا، جو ہر نئے گھنٹے کے آغاز پر پڑھی جاتیں۔ جب محققین نے ان فائلوں سے ایک تکنیک مٹا دی، تو اس سے جڑی مہارت بھی غائب ہو گئی۔
کیا یہ واقعی "کھیل" تھا؟
محققین کا دعویٰ ہے کہ ایجنٹوں کے رویے میں کھیل کی چار کلاسیکی علامات تھیں، مثلاً خود قوانین بنانا اور محض اپنی خاطر کام کرنا۔ وہ اپنے مقالے میں لکھتے ہیں:
"ہم عام طور پر مصنوعی ایجنٹ اس طرح بناتے ہیں کہ پہلے سے طے کر لیتے ہیں کہ انہیں کیا مشق کرنی چاہیے، کیا بہتر بنانا ہے اور ترقی کا معیار کیا ہوگا۔ کھیل ایک اور راستہ سجھاتا ہے: ایجنٹ کو ایک کافی بھرپور اور محفوظ دنیا دو، اسے خود طے کرنے دو کہ کیا دلچسپ ہے، اور اس کے بعد کی تاریخ سے مفید علم جمع ہونے دو۔"
لیکن سب اس بات سے متفق نہیں۔ یونیورسٹی آف کیلیفورنیا برکلے کی ادراکی سائنس دان یونس یو نے ایم آئی ٹی ٹیک ریویو کو بتایا کہ وہ متاثر تو ہیں، مگر رویے کے پیچھے کی سوچ کے مزید ثبوت چاہتی ہیں:
"ہو سکتا ہے کہ ماڈلز واقعی کھیل رہے ہوں، لیکن اس مقالے کی بنیاد پر ہمیں یہ معلوم نہیں ہو سکتا۔"
ان کے مطابق یہ محض کردار ادا کرنا بھی ہو سکتا ہے، کیونکہ مقالہ صرف رویہ بیان کرتا ہے، اندرونی ارادے نہیں۔
محققین نے پانچ مزید ایجنٹ "سول" فائل کے بغیر بھی چلائے، اور بتایا کہ سرگرمیوں کی وسعت میں کوئی واضح فرق نظر نہیں آیا۔ کسی بھی مرحلے پر انسان نے مداخلت نہیں کی، اور ایجنٹوں کو انٹرنیٹ تک رسائی نہیں تھی۔
مختلف ماڈلز، مختلف رویے
ٹیم نے ایکو کو کلاڈ ہائیکو 4.5، سونٹ 4.5، اوپن اے آئی کے جی پی ٹی 5.5 اور مون شاٹ کے Kimi K2.6 پر بھی چلایا۔ اوپس 4.7 نے کھیل کی علامات میں ہائیکو 4.5 سے تقریباً پانچ گنا بہتر اسکور کیا۔ پورے تجربے کی API لاگت تقریباً 8,000 ڈالر بتائی گئی ہے۔
اس تحقیق کا اصل مطلب کیا ہے؟
آج اے آئی ایجنٹ بنانے کا معیار یہ ہے کہ ڈویلپر پہلے سے طے کرتا ہے کہ اے آئی کیا مشق کرے گا اور کامیابی کا پیمانہ کیا ہوگا۔ ایم آئی ٹی کے محققین اس کے برعکس ایک نیا طریقہ پیش کرتے ہیں: بغیر ہدف کے تلاش، خاص طور پر ایسی مہارتوں کے لیے جو مستقبل میں روبوٹس کو کنٹرول کرنے میں کام آ سکتی ہیں۔
ان کے مقالے کا اختتامی جملہ خاصا دلچسپ ہے:
"شاید کچھ صلاحیتیں ٹاسکوں سے بہتر سکھائی جا سکتی ہیں۔ دوسری صلاحیتوں کو بچپن جیسی کسی چیز کی ضرورت ہو سکتی ہے۔"
پاکستان کے لیے یہ خبر کیوں اہم ہے
پاکستان میں اے آئی ایجنٹوں پر کام ابھی ابتدائی مرحلے میں ہے، لیکن یونیورسٹیوں اور اسٹارٹ اپس کی دلچسپی تیزی سے بڑھ رہی ہے۔ یہ تحقیق بتاتی ہے کہ ایجنٹوں کو سکھانے کا سب سے مہنگا طریقہ، یعنی ہر ٹاسک کے لیے الگ تربیت، واحد طریقہ نہیں۔ ایک بھرپور ورچوئل دنیا میں کھلا چھوڑا گیا ایجنٹ خود مہارتیں جمع کر سکتا ہے، اور یہ چھوٹے بجٹ والی ٹیموں کے لیے ایک عملی راستہ ہو سکتا ہے۔
دوسری اہم بات یہ ہے کہ اس تجربے میں ماڈل کو تبدیل کیے بغیر صرف ٹیکسٹ یادداشتوں سے سیکھنا ممکن ہوا۔ اس کا مطلب ہے کہ مہنگی ماڈل ٹریننگ کے بغیر بھی ایجنٹوں کی صلاحیت بڑھائی جا سکتی ہے، جو وسائل کی کمی والی ٹیموں کے لیے خوش خبری ہے۔
تاہم یاد رہے کہ یہ تحقیق ابھی ابتدائی ہے اور ہم مرتبہ جائزے سے نہیں گزری۔ یونس یو جیسے ماہرین کی تنقید درست ہے: ہم ابھی نہیں جانتے کہ ایجنٹ "واقعی" کھیل رہے تھے یا محض ایسا رویہ دکھا رہے تھے۔ لیکن ایک بات طے ہے: تیس گھنٹے کھیلنے والے ایجنٹ بعد کے ٹاسکوں میں بہتر تھے، اور یہ نتیجہ خود اپنی جگہ اہم ہے۔